WEB — Webサイトの基礎
robots.txtとnoindexは止める対象が違う
robots.txtは主にクロールの制御、noindexは検索への索引登録を制御する指示です。どちらも、非公開情報へのアクセスを防ぐ認証の代わりにはなりません。
この記事の目次
検索から外す目的を整理する
公開はするが検索結果へ載せたくないのか、そもそも閲覧を制限したいのかを先に決めます。後者なら認証などのアクセス制御が必要です。検索向けの設定だけで秘密のページになるとは考えないでください。
robots.txtだけで削除できると考えない
クロールを拒否しても、外部リンクなどからURLだけが知られて検索に現れる場合があります。本文を読ませないことと、URLを検索に載せないことは別の扱いです。
noindexを読める状態にする
Googleがnoindexを認識するには対象ページへアクセスできる必要があります。robots.txtで同時にクロールを止めると、ページ内の指示を読めません。HTMLではheadに次のような指定を置けますが、対象を誤ると公開記事まで除外します。
<meta name="robots" content="noindex">公開時に設定の残りを点検する
本番のHTMLとHTTPヘッダーを確認します。テスト環境用のnoindexがテンプレート全体に残っていないか見て、Search Consoleでも対象URLを検査します。変更後の再処理には時間がかかる場合があるため、設定確認と検索表示の確認を分けて記録します。
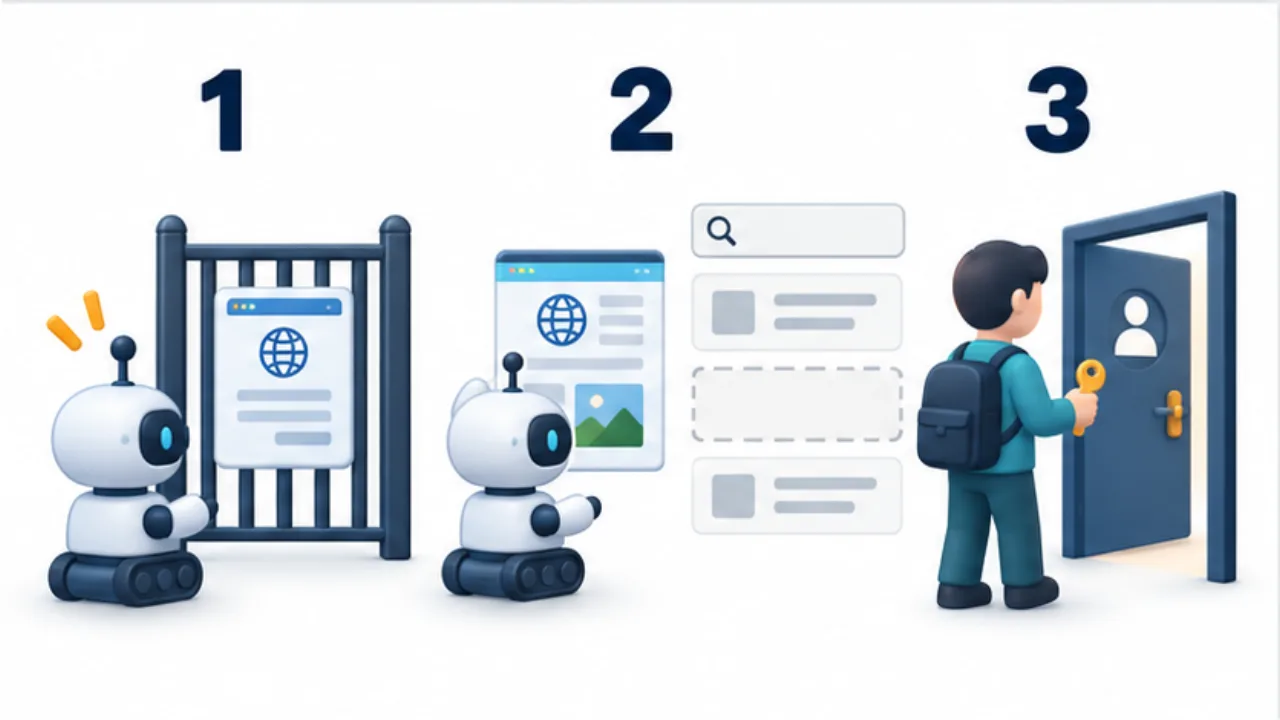
画像を選ぶと拡大できます。
- robots.txtは、クローラーのアクセスを制御する案内です。
- noindexは、ページを読んだ検索エンジンへ掲載しないよう伝えます。
- 秘密にしたいページには、認証などのアクセス制御が必要です。
誰に見せるかを先に分類する
公開ページを検索から外したい場合と、関係者だけに見せたい場合は、解決したい問題が違います。前者は検索での扱い、後者はアクセスできる相手の制限です。ページのURLを知った人が直接開いてよいかを問いにすると、必要な設定を分けやすくなります。
検索向けの指示を付けたことを、非公開化の完了にしないようにします。関係者向けの資料なら、必要なアクセス制御を別に検討します。公開記事を検索へ届けたい場合は、逆にテスト時の制限が残っていないかを調べます。目的が逆のページへ同じテンプレートを適用していないかが確認点です。
テスト用の設定が本番に残った例
制作中は検索に出したくなかったサイトを、本番公開する場面を考えます。トップだけを確認しても、記事のテンプレートにnoindexが残っている可能性は調べ切れません。トップ、記事、カテゴリなど、生成方法の異なるページを代表として選び、本番のHTMLと応答ヘッダーを見ます。
残りが見つかったら、公開したい対象の設定を修正し、生成したファイルと本番の応答を再確認します。設定を直した瞬間に検索結果も変わると考えず、サイト側の修正と検索側の再処理を別々に記録します。現在の検索結果にないことだけで、まだ設定が間違っていると即断しないようにします。
点検対象を表へまとめる
| 目的 | 確認すること |
|---|---|
| 公開記事を検索で見つけてほしい | 不要なnoindexや取得制限が残っていないか |
| 公開ページを検索から外したい | 対象にnoindexがあり、読める条件か |
| 関係者だけが見られるようにしたい | 認証などのアクセス制御 |
| テストと本番を分けたい | 各環境のテンプレートと配信設定 |
robots.txtとページ内の指示を同時に触る場合は、どちらが何を止めるかを説明できるようにします。Googleにnoindexを読ませる必要がある対象を、同時にクロール禁止にしていないか確認します。調査の記録にはページ名だけでなく完全なURLを残し、別環境を見ていないかも照合します。